Ein Sprachmodell setzte mitten in einen deutschen Satz drei kyrillische Buchstaben. Der Satz las sich fehlerfrei – und genau das ist das Problem.
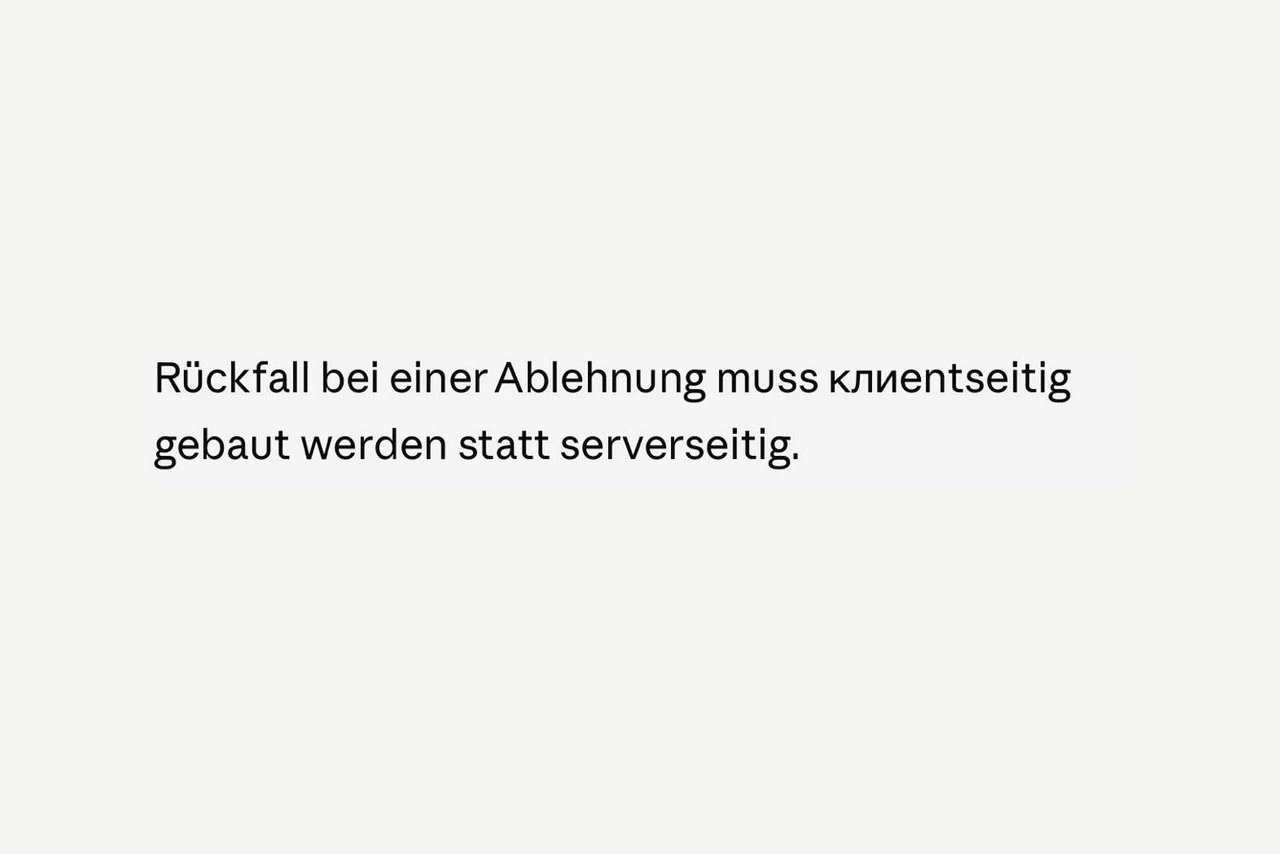
Der Satz auf dem Titelbild stammt aus einer Arbeitssitzung bei Skopa. Er ist grammatikalisch korrekt, er ist fachlich richtig, und er enthält einen Fehler, den in der Sitzung niemand bemerkte: Im Wort «клиentseitig» sind die ersten drei Buchstaben kyrillisch. Aufgefallen ist er erst Stunden später, auf einem Telefonbildschirm, weil dort die Schrift grösser ist. Solche KI-Fehler sind der Grund, warum maschinell erzeugte Arbeit einen zweiten Blick braucht – und warum dieser zweite Blick anders aussehen muss, als die meisten Betriebe ihn sich vorstellen.
Kein Zeichensalat, sondern ein ganzes Wort
Ein Kodierungsfehler zerlegt Text wahllos: Umlaute kippen, Zeichen werden zu Fragezeichen, das Ergebnis sieht kaputt aus. Hier geschah etwas anderes. «кли» ist der Anfang von «клиент» – dem russischen Wort für Klient. Das Modell griff mitten im deutschen Satz zum selben Begriff in einer anderen Schrift und schrieb die Endung auf Deutsch weiter. Es ist ein inhaltlicher Griff daneben in typografischer Verkleidung.
Der Mechanismus dahinter ist keine Störung, sondern eine Eigenschaft. Ein Sprachmodell, das zwanzig Sprachen beherrscht, hält denselben Begriff in zwanzig Formen nebeneinander, und diese Formen liegen dicht beisammen. Ein Wort, das in vielen Sprachen dasselbe bedeutet und ähnlich klingt – Klient, client, клиент –, liegt besonders dicht. Beim Erzeugen des nächsten Wortteils genügt ein kleiner Ausschlag, und es erscheint die Form aus der falschen Sprache. Das Modell hat nicht «falsch gedacht»; es hat den richtigen Begriff in der falschen Schrift ausgegeben.
Nebenbei griff es auch begrifflich daneben: «Klient» ist im Deutschen der Mandant beim Anwalt, die Software heisst «Client». Zwei Fehler in einem Wort, und beide hätten eine Rechtschreibprüfung ausgelöst. Ein Mensch im Lesefluss löste keinen aus.
Warum das Auge hier versagt
Dass solche Wörter durchgehen, ist kein Zufall und keine Unaufmerksamkeit. Etliche kyrillische Buchstaben sind von lateinischen kaum zu unterscheiden, in manchen Schriftarten gar nicht. Das Unicode-Konsortium führt diese Zeichenpaare in einem eigenen Standard und nennt sie «confusables»: Zeichenfolgen, die gleich aussehen, aber aus verschiedenen Schriftsystemen stammen (Unicode Consortium 2026). Das bekannteste Beispiel dort ist eine Adresse, die «paypal» schreibt und dabei zwei kyrillische Buchstaben verwendet – für das Auge identisch, für den Rechner eine andere Adresse.
Was bei Betrugsversuchen Absicht ist, war hier Zufall. Der Effekt ist derselbe. Und er trifft genau die Stellen, an denen ein Betrieb es sich am wenigsten leisten kann:
- Stammdaten: Ein Firmenname mit einem fremden Buchstaben findet sich bei der nächsten Suche nicht mehr. Der Datensatz ist da und bleibt unauffindbar.
- Abgleiche: Zwei Schreibweisen, die für das Auge gleich sind, gelten für jeden Abgleich als verschieden. Der Kunde erscheint doppelt, die Zahlung wird nicht zugeordnet.
- Auswertungen: Eine Filterregel greift nicht, eine Gruppierung fällt auseinander, und in der Summe fehlt ein Betrag, den niemand vermisst.
- Quelltext und Konfiguration: Ein Bezeichner, der gleich aussieht und es nicht ist, erzeugt eine Fehlermeldung, die an der falschen Stelle sucht.
Der Mensch, der nicht mehr hinsieht
Die naheliegende Antwort lautet: dann schaut eben jemand darüber. Die Forschung zur Zusammenarbeit von Mensch und Maschine hält dafür eine unbequeme Beobachtung bereit. Parasuraman und Riley beschrieben schon 1997, dass Menschen automatisierte Systeme in vorhersagbarer Weise falsch gebrauchen – sie verlassen sich zu stark darauf, sobald es eine Weile gut ging (Parasuraman und Riley 1997). Skitka und Kolleginnen zeigten zwei Jahre später im Versuch, dass Menschen mit einer verlässlichen Assistenz Fehler übersehen, die sie ohne diese Assistenz gefunden hätten (Skitka et al. 1999).
Das ist die eigentliche Falle. Eine Maschine, die neunundneunzig Mal einen sauberen Text liefert, erzieht ihren Leser dazu, beim hundertsten nicht mehr hinzusehen. Je besser das Werkzeug, desto flüchtiger die Kontrolle – und desto teurer der eine Fall, der durchrutscht. Eine Freigabe, die aus einem Klick besteht, ist nach zwei Wochen keine Freigabe mehr, sondern eine Gewohnheit.
«Eine Kontrolle, die sich langweilt, kontrolliert nicht mehr.»
Aufsicht heisst nicht Misstrauen, sondern Zuständigkeit
Die Regulierung sagt dazu inzwischen etwas Konkretes. Die KI-Verordnung der EU verlangt für Systeme mit hohem Risiko, dass sie so gebaut sind, dass Menschen sie wirksam beaufsichtigen können – der Text nennt ausdrücklich, dass die aufsichtsführende Person die Grenzen des Systems verstehen und seiner Ausgabe auch widersprechen können muss (Verordnung (EU) 2024/1689, Art. 14). Der Rahmen des amerikanischen Normungsinstituts NIST geht in dieselbe Richtung und verlangt, Risiken über den ganzen Lebenszyklus zu messen statt einmal bei der Einführung (NIST 2023). Für einen Schweizer Mittelstandsbetrieb, der weder Hochrisiko-System noch Normungsprojekt betreibt, bleibt daraus eine schlichte Frage: Wer trägt die Verantwortung für das, was die Maschine erzeugt hat, und woran erkennt diese Person, dass etwas nicht stimmt?
Aus der Antwort folgt eine Arbeitsteilung, die sich in der Praxis bewährt: Was eine Maschine zuverlässig prüfen kann, soll eine Maschine prüfen. Was ein Mensch beurteilen muss, soll ihm ungeprüft gar nicht erst vorgelegt werden.
- Prüfbares maschinell prüfen: Der Fehler aus dem Titelbild lässt sich in einer Zeile abfangen – ein Test, der jedes Zeichen ausserhalb des lateinischen Bereichs zurückweist, mit einer kurzen Liste erlaubter Ausnahmen. Solche Tests gehören in den Bauprozess, nicht in eine Checkliste.
- Dem Menschen nur das Beurteilbare vorlegen: Tonfall, Zahlen im Zusammenhang, Zusagen an einen Kunden. Wer zusätzlich auf Tippfehler achten soll, achtet am Ende auf keines von beidem.
- Die Freigabe an eine Handlung binden: Wer freigibt, ändert etwas – eine Zeile, ein Datum, eine Anrede. Eine Freigabe, die nichts verlangt, wird zur Formsache.
- Festhalten, was die Maschine vorgeschlagen und was der Mensch geändert hat. Erst diese Spur zeigt nach drei Monaten, wo das System schwach ist.
- Stichproben in Ruhe: ein Text pro Woche, ganz gelesen, auf Papier oder in grosser Schrift. Der Fehler in diesem Beitrag fiel genau so auf.
Was daraus für die eigene Arbeit folgt
Ein Werkzeug, das Fehler erzeugt, ist kein schlechtes Werkzeug. Eine Tabellenkalkulation erzeugt auch Fehler, ein Taschenrechner bei falscher Eingabe ebenso. Der Unterschied liegt darin, dass die Fehler eines Sprachmodells gut aussehen: Sie sind grammatikalisch sauber, sachlich plausibel und im Tonfall genau richtig. Deshalb tragen sie weiter als ein offensichtlicher Fehler, und deshalb ist die Frage nach der Aufsicht keine Frage des Vertrauens in die Technik, sondern eine der Arbeitsorganisation.
Bei Skopa steht diese Aufsicht an jeder Stelle, an der etwas nach aussen geht: Der Entwurf kommt von der Maschine, die Freigabe von einem Menschen, und was sich maschinell prüfen lässt, prüft eine Regel im Bauprozess – seit diesem Beitrag auch die Schriftsysteme. Dieser Text ist mit maschineller Hilfe entstanden, gegengelesen und stellenweise umgeschrieben worden. Der Fehler, von dem er handelt, stammt aus derselben Werkzeugklasse. Beides gehört zusammen und beides gehört gesagt.
Wie wir arbeiten und warum bei jedem Lauf dasselbe herauskommt, steht auf der Seite dazu. Methodik →
Quellen
- Europäische Union (2024) Verordnung (EU) 2024/1689 über künstliche Intelligenz, Artikel 14: Menschliche Aufsicht, Amtsblatt der Europäischen Union
- NIST (2023) Artificial Intelligence Risk Management Framework (AI RMF 1.0), National Institute of Standards and Technology
- Parasuraman und Riley (1997) Humans and Automation: Use, Misuse, Disuse, Abuse, Human Factors 39(2), 230–253
- Skitka et al. (1999) Does automation bias decision-making?, International Journal of Human-Computer Studies 51(5), 991–1006
- Unicode Consortium (2026) Unicode Security Mechanisms (UTS #39), Version 18.0.0